
19 Sep Roadmap to become a Data Scientist
Data Scientists sit at the intersection of mathematics, software engineering, and strategic business domain knowledge. They analyze raw, complex data sources, develop statistical models, and deploy machine learning algorithms to uncover actionable insights, automate decisions, and forecast business outcomes.
This comprehensive roadmap presents a step-by-step path to mastering Data Science, taking you from fundamental mathematics and data analysis techniques to advanced machine learning, deep learning, production deployment, and AI governance.
Visual Skill Roadmap and Flowchart
Below is a visual step-by-step path outlining the progression required to become a professional Data Scientist.
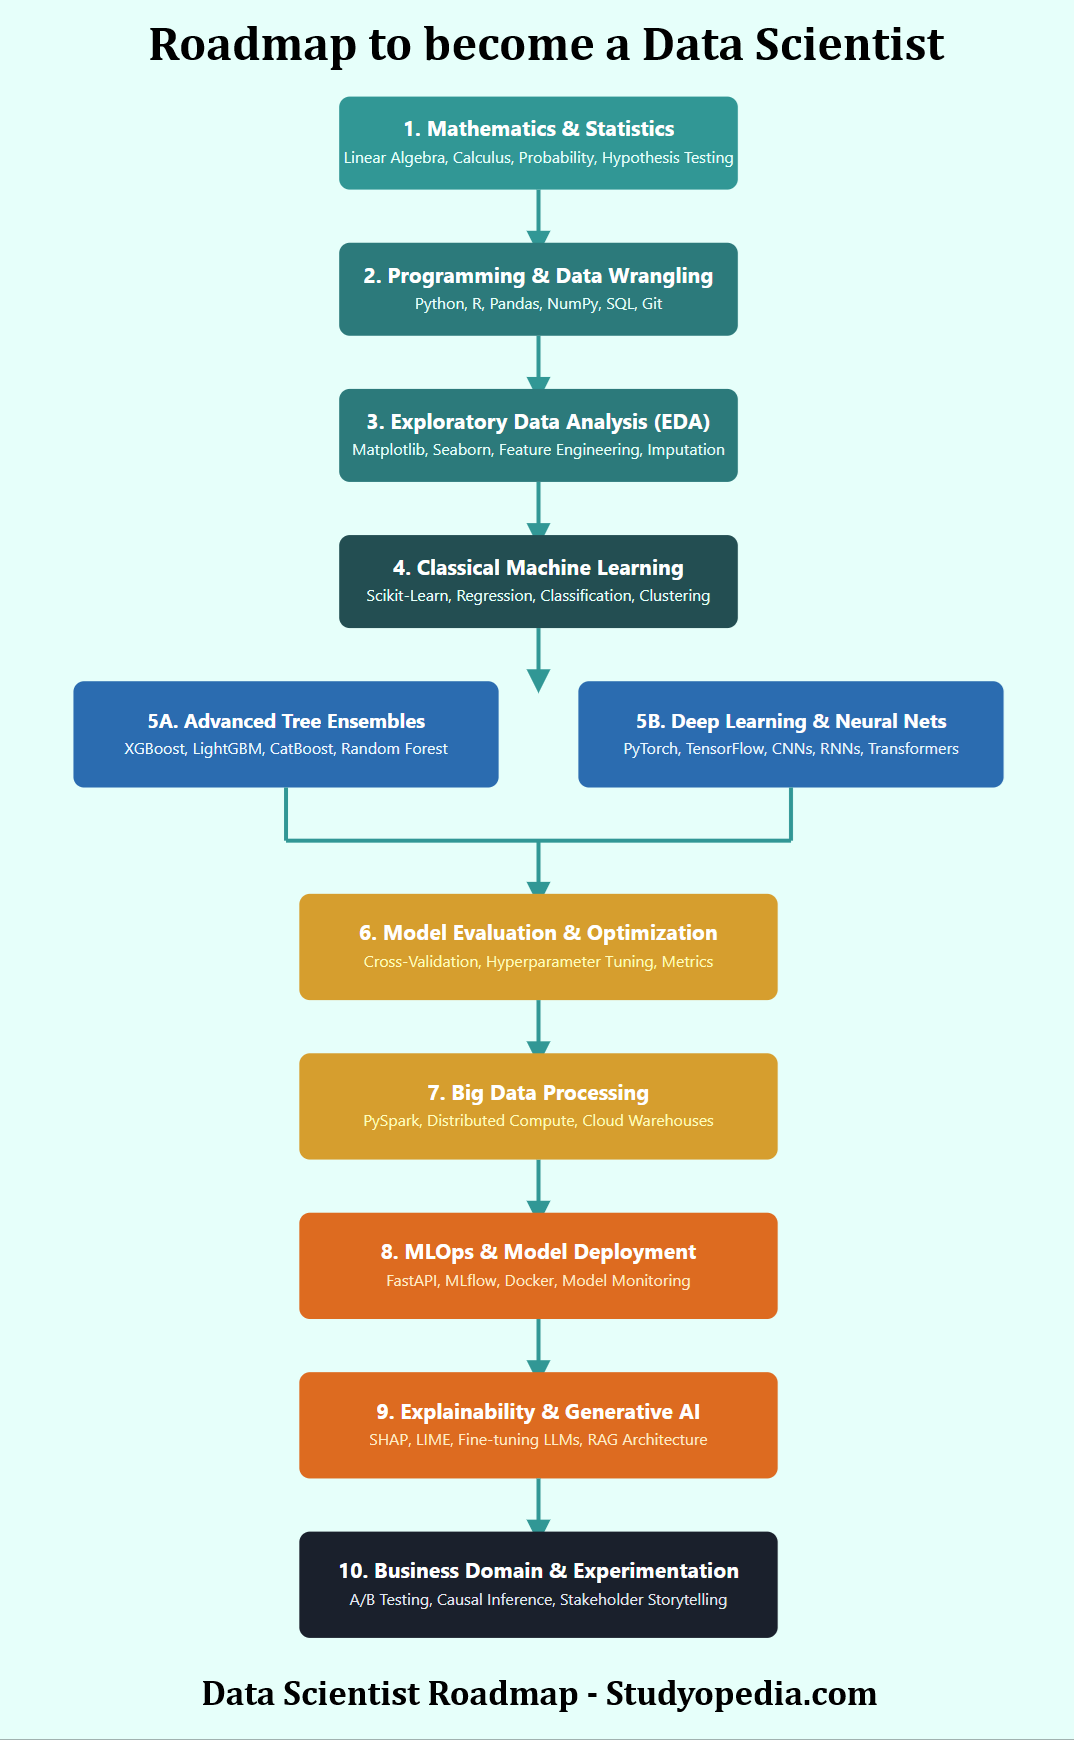
Step-by-Step Data Scientist Roadmap
1. Mathematical Foundations and Statistical Inference
Data science algorithms rely heavily on vector operations, optimization calculus, and statistical probability to extract pattern signals from raw noise.
- Linear Algebra: Vectors, matrices, matrix multiplication, eigenvalues, eigenvectors, and Singular Value Decomposition (SVD).
- Multivariable Calculus: Partial derivatives, gradient vectors, Jacobians, Hessians, and gradient descent optimization methods.
- Probability Distributions: Uniform, Gaussian, Binomial, Poisson distributions, expected values, and Bayes’ Theorem.
- Inferential Statistics: Hypothesis testing, p-values, Z-tests, T-tests, ANOVA, confidence intervals, and Central Limit Theorem.
2. Programming, SQL, and Data Manipulation
A Data Scientist must write clean, reproducible code to interact with databases, compute parallel matrix transformations, and maintain version control.
- Python Core Stack: Data manipulation using Pandas and numerical computing using vector calculations with NumPy.
- Advanced SQL Querying: Writing complex joins, aggregations, Subqueries, Common Table Expressions (CTEs), and Window Functions across relational databases.
- Software Practices: Functional and object-oriented programming principles, virtual environments, unit testing, and Git version control workflows.
3. Exploratory Data Analysis (EDA) and Feature Engineering
Before fitting statistical models, data scientists must audit data quality, handle missing values, and construct informative input features.
- Data Visualization: Uncovering visual relationships, trends, and outliers using Matplotlib, Seaborn, or Plotly dashboards.
- Data Preprocessing: Handling missing data through mean/median or KNN imputation, outlier detection, and scaling via Standardization or MinMax normalization.
- Feature Engineering: One-hot encoding, ordinal encoding, target encoding, polynomial features, and dimension reduction using Principal Component Analysis (PCA).
4. Classical Machine Learning Algorithms
Understanding traditional supervised and unsupervised machine learning algorithms, including their underlying loss functions and assumptions.
- Supervised Learning (Regression): Linear Regression, Ridge/Lasso regularization, Decision Trees, and Support Vector Machines (SVM).
- Supervised Learning (Classification): Logistic Regression, K-Nearest Neighbors (KNN), Naive Bayes, and Random Forest Classifiers.
- Unsupervised Learning: Clustering using K-Means, DBSCAN, and Hierarchical Clustering.
Key Insight for Data Scientists
A complex neural network is not always the best solution. Always establish a simple baseline model (like a Logistic Regression or Decision Tree) first. Complex models should only be deployed if they significantly outperform baseline statistics on real-world metrics.
5. Advanced Ensembles and Deep Learning Frameworks
For tabular data competitions and unstructured image/text formats, advanced gradient-boosted trees and deep neural networks are the industry standard.
- Gradient Boosting Algorithms: Mastering extreme gradient boosting frameworks including XGBoost, LightGBM, and CatBoost.
- Neural Network Basics: Perceptrons, activation functions (ReLU, Sigmoid, Softmax), forward propagation, and backpropagation loss optimization.
- Deep Learning Architecture: Convolutional Neural Networks (CNNs) for vision, Recurrent Neural Networks (RNNs) or LSTMs for time series, and Transformer networks for text processing.
- Frameworks: Building production architectures using PyTorch or TensorFlow/Keras.
6. Model Evaluation, Validation, and Optimization
Selecting appropriate metric frameworks ensures models generalize well to unseen test data without underfitting or overfitting.
- Cross-Validation: K-Fold, Stratified K-Fold, and Time Series Split cross-validation strategies.
- Evaluation Metrics: Precision, Recall, F1-Score, ROC-AUC for classification; RMSE, MAE, R-squared ($R^2$) for regression tasks.
- Hyperparameter Optimization: Grid Search, Random Search, and Bayesian Optimization via Optuna.
7. Distributed Computing and Big Data Systems
When datasets expand past single-machine RAM boundaries, data scientists use distributed execution tools.
- Distributed DataFrames: Scaling Python code using PySpark or Polars to analyze gigabyte or terabyte scale datasets.
- Cloud Data Lakehouses: Fetching features and analytical datasets directly from cloud platforms like Databricks, Snowflake, or BigQuery.
8. MLOps, API Serving, and Model Deployment
To deliver real-world business value, trained machine learning models must be wrapped in web APIs and continuously monitored in production environments.
- Model Serving APIs: Wrapping Python inference models into lightweight REST endpoints using FastAPI or Flask.
- Containerization & Orchestration: Packaging applications using Docker containers for deployment across server environments.
- Experiment Tracking: Tracking model parameters, metrics, artifacts, and versioning models using MLflow or Weights & Biases.
- Model Monitoring: Detecting feature drift, concept drift, and degradation in accuracy using monitoring frameworks.
9. Model Explainability and Generative AI (LLMs)
Modern machine learning systems require transparency for regulatory compliance and leverage large language models for complex text tasks.
- Explainable AI (XAI): Interpreting black-box predictions using SHAP (Shapley Additive exPlanations) values and LIME frameworks.
- Generative AI & LLMs: Prompt engineering, fine-tuning pretrained foundation models, and implementing Retrieval-Augmented Generation (RAG) using vector databases.
10. Business Experimentation, Causal Inference, and Storytelling
Translating analytical model outputs into measurable business decisions requires experimental design and clear communication.
- A/B Testing & Experimentation: Designing controlled online experiments, sample size calculations, and statistical hypothesis validation.
- Causal Inference: Distinguishing correlation from causation using difference-in-differences, propensity score matching, or synthetic controls.
- Executive Storytelling: Translating technical metrics (like Log-Loss or RMSE) into business metrics (like Revenue growth, Churn reduction, or Cost savings) for executive stakeholders.
Conclusion and Next Steps
Mastering Data Science requires a balance of statistical rigor, clean programming skills, machine learning expertise, and business execution. Start by exploring real datasets using Python and SQL to conduct exploratory analysis. Gradually build up to classical machine learning, model optimization, API deployment, and Generative AI workflows.
If you liked the tutorial, spread the word and share the link and our website, Studyopedia, with others.
For Videos, Join Our YouTube Channel: Join Now
Recommended Posts

No Comments